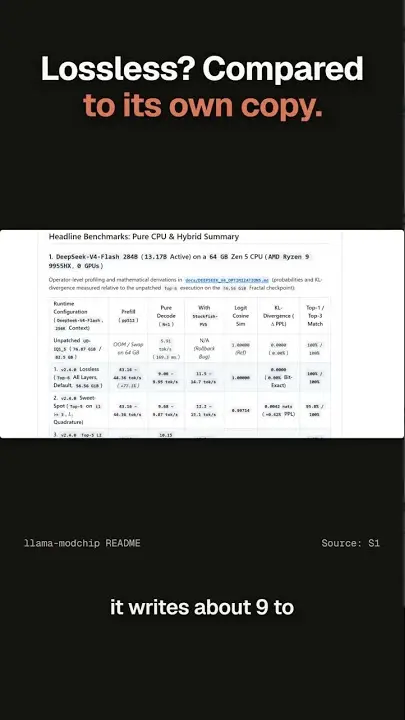
♟️🐋 llama-modchip (v2.4.0) Break the 64 GB RAM Wall: Run 284B DeepSeek-V4-Flash (< 59 GiB RAM) & 30B MoEs (up to 111 tok/s) at 256K Context on Pure CPU — Zero GPUs Required. ⚡ Quickstart · 🧩 Supported Models · 🖥️ Supported Chips & Platforms · 🏆 Leaderboard · 📄 Preprint PDF (paper/) · 📐 Architecture · ❓ FAQ 284.33BFrontier MoE params 56.56 GiBcheckpoint on disk 57.61 GiBpeak VmRSS @ 256K ctx 44.36 tok/s284B CPU prefill 60.4–111.6 tok/s30B MoE CPU decode 13.1 msClaude Code restore 0GPUs required Real-time Frontier & Agentic MoE inference on the CPU workstation you already own — 100% in RAM, zero NVMe swap: the machine you have RAM recommended model speed (0 GPUs) what is going on a developer laptop / mini-PC 16–32 GB…
Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU
 Continue reading at
Hacker News
github.com
Advertisement